
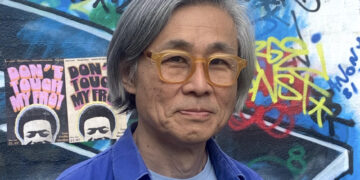
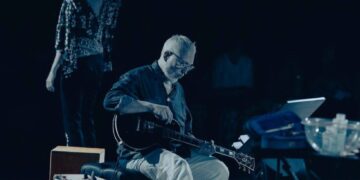



Compositore, performer, ricercatore e professore di Media Computing presso la Goldsmiths, University of London, Atau Tanaka ripercorre la propria storia artistica, il contesto e ciò che lo ha ispirato in vista della pubblicazione del suo nuovo libro, Body Music: Phenomenologies of Sonic Gesture (Goldsmiths Press, 2026).
Nel corso di quasi quattro decenni di sperimentazione, Tanaka ha utilizzato il corpo come strumento musicale elettronico, in particolare attraverso il rilevamento dei gesti e la loro trasformazione in suono. La combinazione della sua formazione classica, degli studi di musica elettronica con Ivan Tcherepnin alla Harvard University e di musica informatica con John Chowning presso il CCRMA della Stanford University, insieme alla sua straordinaria versatilità e curiosità intellettuale, lo ha reso un pioniere nell’esplorazione delle relazioni tra corpo, musica e tecnologia, nonché una delle figure fondatrici dell’interazione uomo-computer applicata alla musica (Music Human-Computer Interaction, Music HCI). Dalle performance degli anni Novanta con il BioMuse — un dispositivo sviluppato da ricercatori in ambito biomedico per rilevare i segnali muscolari (EMG) e cerebrali (EEG), che Tanaka trasformava in suono — fino ai lavori più recenti con l’apprendimento automatico (machine learning) e le reti generative avversarie (GAN), l’artista ha attraversato il passaggio dall’analogico al digitale, confrontandosi costantemente con ogni nuova evoluzione tecnologica.
Eppure, non ha mai perso di vista alcuni sogni e aspirazioni nati nell’epoca analogica. Tra questi, un suono che scaturisce direttamente dal corpo e prende forma nel gesto e uno strumento che diventa un’estensione del corpo stesso. C’è poi la malleabilità del suono analogico, che cerca di recuperare nel digitale, anche quando lavora con l’intelligenza artificiale. L’intervista si è svolta il 12 ottobre 2026 nello studio di Atau Tanaka presso la Goldsmiths, University of London.

Elena Giulia Rossi: Quando hai iniziato a lavorare con BioMuse, sviluppato a Stanford alla fine degli anni Ottanta, qual era il contesto più ampio dell’innovazione tecnologica e della sperimentazione artistica, in particolare quella cresciuta al crocevia tra arte, musica e tecnologia? E come è cambiato da allora quel contesto?
Sono attivo da quasi quarant’anni, dalla fine degli anni Ottanta al primo quarto del XXI secolo. Quando ho iniziato eravamo ancora molto legati alle estetiche e alle idee degli anni Sessanta: la trasformazione della società, la cultura giovanile, la cultura psichedelica, lo smantellamento delle strutture sociali. Tecnologia e musica esistevano dentro tutto questo. E credo che la musica e le tecnologie del suono abbiano da sempre anticipato i tempi: il suono digitale è arrivato prima del video digitale. Forse, come musicisti, abbiamo avuto una visione precoce dei cambiamenti.
Il punto cruciale, allora, era il passaggio dall’analogico al digitale. Fu importantissimo per le tecnologie del suono di tutti i giorni. La registrazione catturava un segnale analogico continuo su nastro magnetico o su vinile. Ora diventava una rappresentazione digitale, un flusso di dati binari impresso su un CD. C’era un’enorme speranza in tutto questo, e io sono stato senz’altro tra i primi ad adottarlo, ma con solide radici nell’analogico: strumenti acustici, pianoforte, chitarra. Gli strumenti, come la chitarra, venivano elettrificati, ma restavano analogici. Ho studiato musica elettronica su sistemi analogici e ho aiutato il mio professore Ivan Tcherepnin a installare il nuovo studio digitale all’Harvard Electronic Music Studio. Sento, quindi, di appartenere alla generazione della transizione, quella che ha accolto il digitale senza lasciar andare l’esperienza del mondo che avevamo conosciuto attraverso l’analogico.
È questo che cerco sempre di portare nel digitale: una possibilità di espressività e di continuità che spesso diamo per assente. Pensiamo al digitale come a qualcosa di binario e in qualche modo di rigido, capace di fare copie perfette ma fragile. Io ho sempre pensato che avesse un potenziale fluido, organico. E oggi, con il deep learning, il machine learning e l’IA, il viaggio continua. Siamo passati dall’analogico al digitale, dal segnale ai dati, e ora i dati vengono elaborati su una scala così vasta che abbiamo a che fare semplicemente con l’informazione. Da tutto questo emerge la conoscenza, emerge la musica.
Quindi, per rispondere alla tua domanda, nel tempo sono cambiate le sfide. Io però sono rimasto fedele ad alcuni dei sogni e degli obiettivi originari dell’epoca analogica. Credo che anche nella registrazione e nella rappresentazione digitale del suono si possa recuperare parte della malleabilità dell’analogico. È così che lavoro oggi con l’IA e con i sistemi di informazione.
Nei tuoi esperimenti di performance in rete negli anni Novanta, i ritardi di trasmissione diventavano parte dell’opera, trasformando l’intervallo tra gesto e risposta in materiale compositivo. Guardando a lavori più recenti, come Gesture-Timbre Space (con Federico Visi, 2021), in che modo l’arrivo del machine learning ha trasformato la tua idea di controllo? Il comportamento predittivo di questi sistemi mette in discussione l’agency dell’interprete, o apre nuove possibilità di interazione ed espressione?
Per rispondere, credo che la parola problematica sia “controllo”. Il paradigma è cambiato nel tempo. Pensavamo che il digitale potesse darci un controllo maggiore: era affidabile, riproducibile, e quindi poteva essere più deterministico. In quei primi tempi sembrava una cosa interessante.
Tuttavia, proprio negli anni da studente, mentre stavo finendo a Harvard, ho conosciuto John Cage, in occasione delle Norton Lectures. Il mio professore, Ivan Tcherepnin, lo ospitava, e io fui invitato a cena con loro. Cage abbracciava la rinuncia al controllo, e i movimenti artistici nati da Fluxus erano molto in quello spirito, come pure il free jazz. Ma la possibilità di controllo offerta dai sistemi digitali restava attraente.
Ora, se Cage era un compositore occidentale che abbracciò la filosofia orientale e accolse l’indeterminazione rinunciando al controllo, è stato proprio perché era una persona che controllava. Sapeva cosa voleva. Ho amici che hanno suonato le sue opere: lui veniva alle prove, i musicisti suonavano quello che credevano un brano aperto, e lui diceva: “No, non è così che deve essere”. Se si interessava alla filosofia orientale, è perché era un uomo molto occidentale. Quindi rinunciare al controllo è una condizione del controllo. O forse il voler controllare è una condizione per apprezzare il fatto che il controllo non c’è.
Ma quel paradigma resta. Gli strumenti musicali costruiti in quegli anni, gli strumenti MIDI, si chiamavano MIDI Controller. La parola è lì. E oggi, man mano che le tecnologie digitali sono state assorbite nella vita quotidiana, questo è avvenuto in un modo totalmente controllato, attraverso i poteri governativi e aziendali. Notandolo, e avendo avuto il controllo, la riproducibilità e la determinatezza dei sistemi digitali, mi sono reso conto sempre di più che non era davvero questo a interessarmi.
Così ho rinunciato al controllo, o meglio, ho capito qualcosa della musica così come la suonavamo. Pensavamo che imparare uno strumento significasse padroneggiarlo, controllarlo sempre meglio in modo virtuosistico. In realtà si crea una relazione con lo strumento. In Global String, il ritardo di rete faceva parte della sintesi del suono. I pacchetti di dati dovevano viaggiare da un luogo a un’altra città e tornare indietro, e quel ritardo condizionava il suono della corda. Per me era una trasposizione diretta del corpo acustico risonante di un violino. Così ho pensato al ritardo come a una qualità risonante.

In Global String (1999-2000), il ritardo diventava quindi parte del corpo dello strumento. Si poteva controllare quella risonanza? La rete condizionava il suono in modo prevedibile?
No, non è prevedibile, perché internet e la trasmissione a pacchetti erano stati progettati per resistere agli attacchi militari. La rete era resistente perché decentralizzata, e con protocolli come il TCP, Transmission Control Protocol, ciò che si controllava non era quando ma se i dati sarebbero arrivati. Per garantire che i dati passassero da un punto all’altro nonostante la possibilità di un attacco, i pacchetti avevano bisogno di un instradamento dinamico che riuscisse a trovare la destinazione, a prescindere dal tempo necessario. Non sapevamo quale percorso avrebbero intrapreso. Qui entriamo nelle questioni del routing di rete, dei gateway, del ping. Non sapevamo quindi quando i dati avrebbero raggiunto la destinazione e sarebbero tornati. Sapevamo però quando arrivavano, e avevamo comandi per scoprire quanto tempo, quanti millisecondi, ci avevano messo. Era quindi qualcosa di profondamente indeterminato, del tutto fuori dal nostro controllo, ma era anche una qualità, una qualità risonante, quella che riconosco nel suono.
Ti interessava tracciare il percorso dei dati, le città e i gateway che attraversavano? Quanto quella ricostruzione del viaggio era parte dell’opera?
Sì mi interessava molto ed era parte della visualizzazione di Global String. Traceroute era una semplice utility che tracciava quali gateway, quali città, attraversava un pacchetto di dati per andare dal punto A al punto B, e il ritardo tra un gateway e l’altro. Per me era una cosa molto musicale.
Con il machine learning è diverso. In Gesture-Timbre Space, con Federico Visi, ci interessavano reti neurali molto semplici, configurate per quella che chiamiamo modellazione per regressione. La regressione consiste nel cercare automaticamente una mappatura matematica, semplicemente una funzione che approssima una curva, che insegniamo a un sistema. Come dati di addestramento forniamo esempi di input e output. Questi esempi sono composti, ma non componiamo l’intera gamma delle possibilità. Componiamo alcuni esempi dentro quello che poi diventa uno spazio infinito: punti in cui un gesto è associato a un certo suono.
In questo caso semplice di machine learning, però, abbiamo dovuto ridurre fenomeni continui a punti: il gesto come movimento del corpo, il suono come variazione della pressione dell’aria. Li abbiamo ridotti a due parametri, input e output. E se il corpo diventa un punto, non si muove. Il gesto si riduce a una postura, a una posizione.
Se è vero che la postura dell’interprete diventa l’input del sistema, come si traduce in suono questa informazione legata al corpo?
La postura è l’input, e il suono che le associamo è l’output. Ma non è un suono continuo, è un suono parametrico: filtro, amplificatore, oscillatore. Abbiamo associato posizioni del corpo a parametri sonori, ne abbiamo fornito un certo numero di esempi come set di addestramento e abbiamo lasciato che la rete neurale costruisse un modello di regressione. Questo ha creato uno spazio continuo che collega tutti i singoli punti. Se i punti sono ancoraggi in un futuro spazio informativo, l’algoritmo di machine learning crea, o meglio tesse, lo spazio informativo continuo tra i punti discreti che abbiamo fornito.
Che cosa impara davvero la macchina da queste associazioni tra postura e suono? E in che modo questo processo di apprendimento influisce sull’interazione dell’interprete con il sistema?
Io non insegno alla macchina ad avere un gesto. Ma una volta creato il modello di regressione, possiamo suonare insieme. C’è quindi una fase di addestramento e una fase di esecuzione. La fase di addestramento è molto compositiva: è fatta di punti. Il modello diventa poi uno spazio informativo vivo dove possiamo suonare. E suoniamo con i gesti, con un corpo in continuo movimento che naviga lo spazio gesto-suono e crea un suono in continua trasformazione.
Quando suoni, c’è ancora spazio per l’imprevedibile? O il modello restituisce semplicemente ciò che gli ha insegnato?
Be’, c’è sempre qualche sorpresa; ci sono spazi intermedi che non avevamo previsto quando gli abbiamo fornito i punti discreti. Alcuni di questi spazi sono inattesi, ma hanno senso, perché ci muoviamo tra due luoghi definiti che conosciamo. È una forma di interpolazione: anche quando sorprende, più o meno ha senso. Ma diventa davvero interessante quando ci accorgiamo di non essere vincolati allo spazio su cui l’abbiamo addestrato: possiamo andare oltre. Quando il gesto esce dai confini degli esempi forniti, il modello di regressione continua a funzionare, e non stiamo più interpolando ma estrapolando. È qui che possono arrivare le vere sorprese. Non si tratta quindi di indeterminazione in senso stretto, di uno stato di non-controllo, ma della condizione di suonare oltre le condizioni iniziali che abbiamo fornito. La macchina è in grado di restituire qualcosa di estrapolato, qualcosa che va oltre ciò che avevamo immaginato.

In Delearning (2019) hai costruito il dataset dal vivo, attraverso la performance stessa. Puoi raccontarci di questo lavoro?
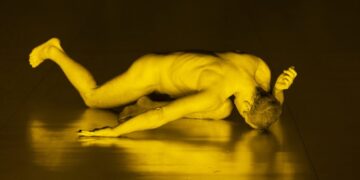
In Delearning volevo rendere visibile il processo di apprendimento nella drammaturgia. Inizio il brano con una tabula rasa, un set di dati vuoto, e l’inizio è molto statico: cerco pose, posizioni del corpo, suoni statici e ripetitivi. Quando l’algoritmo è addestrato con soli due punti, otteniamo un’interpolazione morbida tra di essi. Poi, attraverso il flusso di lavoro del machine learning interattivo, aggiungo un terzo punto, poi un quarto, e lo spazio informativo diventa più multidimensionale, più ricco. Questo processo è esposto al pubblico come drammaturgia e insieme come struttura compositiva della performance.
Il titolo significa prendere l’apprendimento e disfarlo, perché diamo per scontato che nel machine learning sia la macchina a imparare l’essere umano. Ma dal punto di vista dell’interazione uomo-computer non si tratta di un insegnamento e di un apprendimento a senso unico. Penso all’interazione, o all’intra-azione di Barad, e a un’idea di partnership tra umano e macchina. Non stiamo solo insegnando alla macchina. Se la macchina ci restituisce qualcosa di inatteso e mai sentito, allora è l’umano a imparare le dinamiche del sistema. C’è quindi un apprendimento umano e c’è un apprendimento automatico.

Passando dal machine learning alle GAN, come cambia il tuo rapporto con l’imprevedibilità e con la macchina stessa?
Le GAN, le reti generative avversarie (generative adversarial networks), sono un’estensione delle stesse reti neurali usate nel lavoro di mappatura precedente. Queste ultime sono a loro volta un’estensione delle reti neurali inventate da Frank Rosenblatt negli anni Cinquanta. Qui però sono configurate in modi sempre più sofisticati: la macchina può formulare proposte ed entrare in relazioni avversarie con sé stessa, verificando se una proposta generata corrisponde a un esempio reale, a una ground truth. Entriamo così nelle tecnologie contemporanee del deep learning, quelle che troviamo oggi nei grandi modelli linguistici e nell’arte visiva generativa. Come compositore e musicista, volevo capire come pensare tutto questo in chiave musicale e sonora.
C’è un’enorme dimensione etica legata alla provenienza dei dati, cioè al sapere da dove vengono. Se generiamo qualcosa di nostro, ma in un rapporto avversario con l’intera storia dell’arte musicale, da dove viene quel materiale? È stato raccolto in modo etico? Non voglio usare il modello di dati di qualcun altro. Non voglio usare un modello che rappresenti l’intera storia della musica occidentale.

Così ho iniziato a creare modelli dei musicisti che avrebbero eseguito la mia musica. Nel processo compositivo e nella collaborazione con gli interpreti c’è una fase in cui catturiamo gli esecutori e la loro pratica musicale con lo strumento. Finora i brani sono due. Il primo è per l’ensemble di percussioni ginevrino Eklekto, nato durante una residenza agli Art Zoyd Studios in Francia. Ho lavorato con un trio di percussionisti e ho registrato ore e ore delle loro improvvisazioni libere: non gli strumenti a percussione in sé, ma loro mentre li suonavano. Il secondo è un brano vocale. Mi è stato commissionato dal basso-baritono Nicholas Isherwood, che vive a Venezia, per la sua voce e l’IA. Ho preso registrazioni di Isherwood che interpretava musiche di John Cage, Mauricio Kagel e George Crumb e ne ho ricavato un modello di dati. In questo modo poteva cantare la mia musica attraverso un modello della propria voce.
In entrambe le opere i musicisti suonano con modelli di sé stessi. Per questo è un lavoro etico: conosciamo la provenienza dei dati. E c’è anche una sorta di identità, a un certo livello, che secondo me dà una certa coerenza estetica. Ma poi entra in gioco l’ignoto, perché il sistema è imperfetto. Abbiamo modellato la voce di Isherwood sulle sue registrazioni, quindi è la sua voce, ma è lui che canta musica di altri compositori. Se avessimo modellato Isherwood che canta Cage e lui cantasse poi lo stesso brano di Cage, il modello dovrebbe restituire un risultato identico. Invece lui canta un’altra musica con la sua voce, e il modello cerca di ricondurla ai suoni che aveva prodotto articolando la musica di Cage. Così la sua voce si straniа in un modo davvero sorprendente.
Nel brano per percussioni abbiamo modellato i percussionisti mentre suonavano i timpani orchestrali. L’esecuzione però si è svolta in un piccolo spazio sotterraneo di Ginevra, la Cave 12, dove non c’era posto per strumenti orchestrali. La partitura prevedeva quindi i rototom: pelli di tamburo senza corpo ma dal suono profondo. Suonare i rototom dal vivo attraverso il modello dei timpani produce risultati sorprendenti. In queste opere basate sulle GAN, dunque, i musicisti suonano con un’ombra di sé stessi, una sorta di avatar. È un avatar imperfetto, che sposta strumenti, articolazioni musicali e suoni. Ma restano loro, e resta la mia musica.

Il tuo prossimo libro, Body Music: Phenomenologies of Sonic Gesture (Goldsmiths Press, 2026), ripercorre tutto il tuo percorso artistico, riunendo i tuoi modelli teorici e i tuoi lavori più recenti con l’intelligenza artificiale. Come è nata l’idea del libro? Puoi darci un’anticipazione dei contenuti?
Mi interessava il gesto: eseguo musica elettronica e informatica con il corpo, con movimenti gestuali, e volevo scrivere un libro su questo. Ma ci lavoro da più di dieci anni. Quello che intendevo scrivere dieci anni fa non corrisponde a dove siamo oggi, e io stesso non sono più dove ero allora. Oggi esiste un’enorme letteratura su gesto e musica, che ho letto e a cui spero di contribuire.
In questo frangente di tempo ho capito che il modo in cui lavoro con il corpo aggiungeva dimensioni a ciò che stavo scrivendo. Lo uso in parte come strumento musicale, in parte come un altro inconoscibile, o come me stesso. Sapevo di voler scrivere del gesto, e infatti c’è un capitolo dedicato, ma il libro nel suo insieme non parla più solo di quello. Mi sono reso conto che c’è anche un pensiero strumentale musicale. Viene dai miei studi di composizione, dall’idea di quella che chiamiamo scrittura idiomatica. Significa scrivere secondo l’idioma dello strumento, conoscerlo con i suoi limiti e spingere oltre quegli idiomi. E pensare il corpo come strumento musicale proprio in questo senso.
Mi sono reso conto sempre di più di essere in realtà un compositore-interprete. Non tutti i compositori si esibiscono, ma per me questa ricorsività è molto produttiva sul piano creativo. Così nel libro è entrata la performance, e con essa i performance studies, la performance art e la teoria di Peggy Phelan.
Il pensiero sul corpo fa da cornice all’inizio e alla fine del libro. C’è la teoria del corpo, come la sintetizza Lisa Blackman, e c’è la body art: guardo non solo alla mia musica del corpo ma anche a quella di altri, compresa un’opera fondamentale di Yoko Ono. Il libro si chiude di nuovo sul corpo, in una prospettiva non occidentale e non cartesiana. Lì mente e corpo non sono separati in un dualismo cartesiano ma intesi come un’unità, come accade nel buddhismo zen e nelle filosofie della mia cultura, quella giapponese. Per me è stato quindi un percorso personale.
E da qualche parte nel mezzo, visto quanto tempo ci ho messo a scriverlo… oggi non si potrebbe scrivere un libro senza un capitolo sull’IA. Nel frattempo, si dà il caso che avessi realizzato lavori musicali sulla mappatura gesto-suono e sulla modellazione generativa di cui abbiamo appena parlato. Questi lavori sono letti attraverso la lente della storia sociale marxista dell’IA di Matteo Pasquinelli.
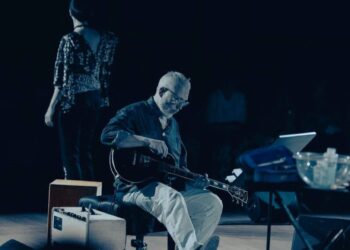
immagini: (cover – 1) Atau Tanaka, ritratto, fotografia di Annika Ström (2) Atau Tanaka durante la performance “Myogram”, fotografia di Martin Delaney (3) Atau Tanaka, “Global String”, collegamento tra V2_ Rotterdam e Ars Electronica Center di Linz, 2001 (4) Atau Tanaka durante la performance “Delearning” presso Iklectik, Londra, 2021 (5) Interfaccia RAVE di Atau Tanaka per “Transfert”, fotografia di Olive (6) Atau Tanaka, “Transfert”, eseguito dall’ensemble Eklekto presso Cave12, Ginevra, 2026, fotografia di Olive (7) Atau Tanaka, “Body Music. Phenomenology of Sonic Gesture”, Goldsmiths Press, 2027, copertina